ERF
Energy Research and Forecasting: An Atmospheric Modeling Code
ERF_EBAdvectionSrcForState.cpp File Reference

Implements EB advection source terms for density and scalar state. More...

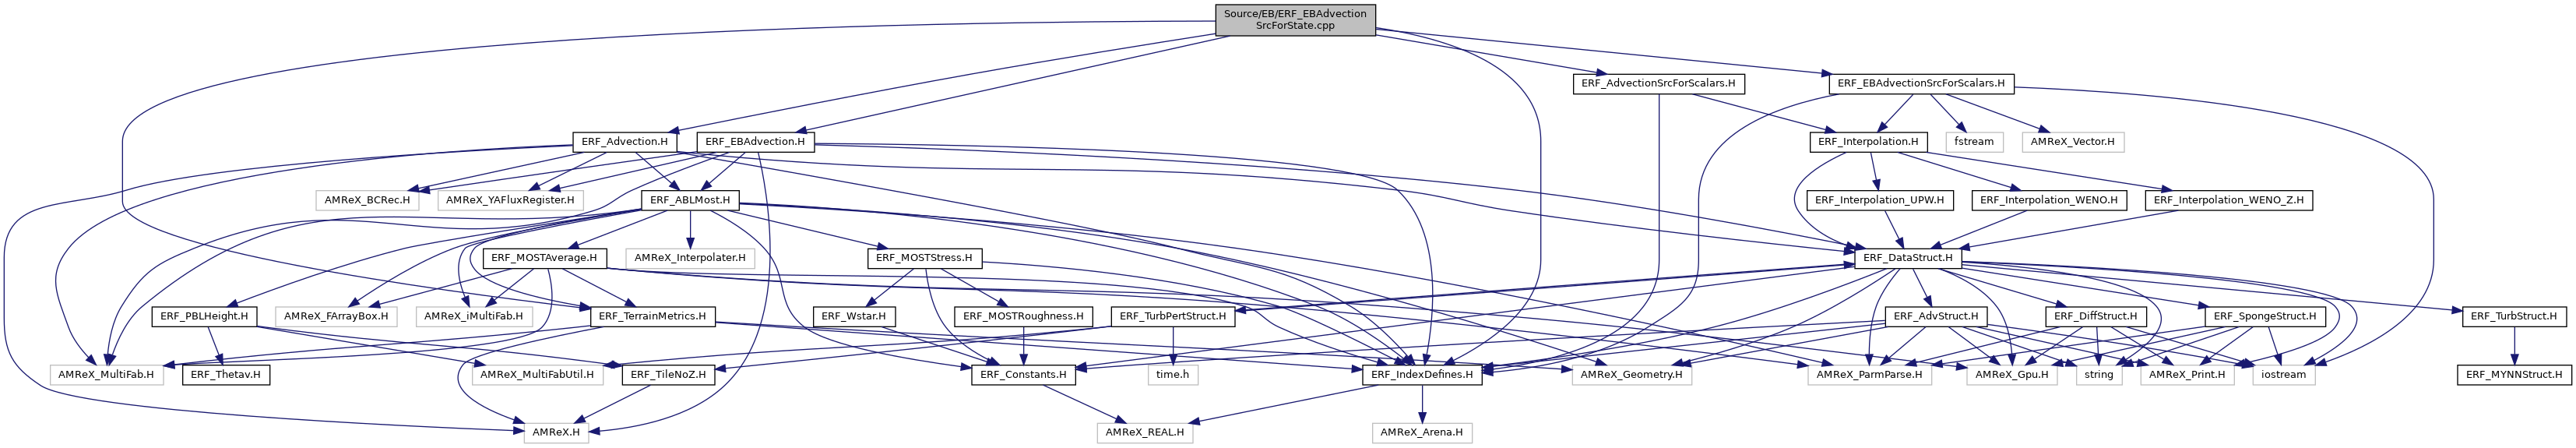
Include dependency graph for ERF_EBAdvectionSrcForState.cpp:
Functions

void EBAdvectionSrcForRho (const Box &bx, const Array4< Real > &advectionSrc, const Array4< const Real > &rho_u, const Array4< const Real > &rho_v, const Array4< const Real > &Omega, const Array4< Real > &avg_xmom, const Array4< Real > &avg_ymom, const Array4< Real > &avg_zmom, const Array4< const int > &mask_arr, const Array4< const EBCellFlag > &cfg_arr, const Array4< const Real > &ax_arr, const Array4< const Real > &ay_arr, const Array4< const Real > &az_arr, const Array4< const Real > &fcx_arr, const Array4< const Real > &fcy_arr, const Array4< const Real > &fcz_arr, const Array4< const Real > &detJ, const GpuArray< Real, AMREX_SPACEDIM > &cellSizeInv, const Array4< const Real > &mf_mx, const Array4< const Real > &mf_my, const Array4< const Real > &mf_uy, const Array4< const Real > &mf_vx, const GpuArray< const Array4< Real >, AMREX_SPACEDIM > &flx_arr, const bool fixed_rho, bool already_on_centroids)
 Compute the EB advective tendency for rho and rho theta. More...
 
void EBAdvectionSrcForScalars (const Box &bx, const int icomp, const int ncomp, const Array4< const Real > &avg_xmom, const Array4< const Real > &avg_ymom, const Array4< const Real > &avg_zmom, const Array4< const Real > &cell_prim, const Array4< Real > &advectionSrc, const Array4< const int > &mask_arr, const Array4< const EBCellFlag > &cfg_arr, const Array4< const Real > &ax_arr, const Array4< const Real > &ay_arr, const Array4< const Real > &az_arr, const Array4< const Real > &fcx_arr, const Array4< const Real > &fcy_arr, const Array4< const Real > &fcz_arr, const Array4< const Real > &detJ, const GpuArray< Real, AMREX_SPACEDIM > &cellSizeInv, const Array4< const Real > &mf_mx, const Array4< const Real > &mf_my, const AdvType horiz_adv_type, const AdvType vert_adv_type, const Real horiz_upw_frac, const Real vert_upw_frac, const GpuArray< const Array4< Real >, AMREX_SPACEDIM > &flx_arr, const Box &domain, const BCRec *bc_ptr_h, bool already_on_centroids)
 Compute the EB advective tendency for scalars. More...
 

Detailed Description

Implements EB advection source terms for density and scalar state.

Function Documentation

◆ EBAdvectionSrcForRho()

void EBAdvectionSrcForRho ( const Box &  bx,
const Array4< Real > &  advectionSrc,
const Array4< const Real > &  rho_u,
const Array4< const Real > &  rho_v,
const Array4< const Real > &  Omega,
const Array4< Real > &  avg_xmom,
const Array4< Real > &  avg_ymom,
const Array4< Real > &  avg_zmom,
const Array4< const int > &  mask_arr,
const Array4< const EBCellFlag > &  cfg_arr,
const Array4< const Real > &  ax_arr,
const Array4< const Real > &  ay_arr,
const Array4< const Real > &  az_arr,
const Array4< const Real > &  fcx_arr,
const Array4< const Real > &  fcy_arr,
const Array4< const Real > &  fcz_arr,
const Array4< const Real > &  detJ,
const GpuArray< Real, AMREX_SPACEDIM > &  cellSizeInv,
const Array4< const Real > &  mf_mx,
const Array4< const Real > &  mf_my,
const Array4< const Real > &  mf_uy,
const Array4< const Real > &  mf_vx,
const GpuArray< const Array4< Real >, AMREX_SPACEDIM > &  flx_arr,
const bool  fixed_rho,
bool  already_on_centroids 
)

Compute the EB advective tendency for rho and rho theta.

This routine forms density fluxes, stores momentum averages for later scalar advection, and evaluates the EB-aware divergence at cell centers.

Parameters
[in]bxBox over which the state is updated.
[out]advectionSrcTendency for the density update equation.
[in]rho_ux-component of momentum.
[in]rho_vy-component of momentum.
[in]OmegaMomentum component normal to the z-coordinate surface.
[out]avg_xmomx-face momentum average defined by this routine.
[out]avg_ymomy-face momentum average defined by this routine.
[out]avg_zmomz-face momentum average defined by this routine.
[in]mask_arrCell-centered mask used for EB face interpolation.
[in]cfg_arrCell-centered EB flags.
[in]ax_arrArea fraction on x-faces.
[in]ay_arrArea fraction on y-faces.
[in]az_arrArea fraction on z-faces.
[in]fcx_arrFace centroid on x-faces.
[in]fcy_arrFace centroid on y-faces.
[in]fcz_arrFace centroid on z-faces.
[in]detJJacobian of the metric transformation.
[in]cellSizeInvInverse grid spacing.
[in]mf_mxx-direction map factor at cell centers.
[in]mf_myy-direction map factor at cell centers.
[in]mf_uyMap factor used for x-momentum fluxes.
[in]mf_vxMap factor used for y-momentum fluxes.
[out]flx_arrDirectional flux arrays.
[in]fixed_rhoWhether density tendency is forced to zero.
[in]already_on_centroidsWhether EB geometric data are already centroid-adjusted.
73 {
74  BL_PROFILE_VAR("EBAdvectionSrcForRho", EBAdvectionSrcForRho);
75  auto dxInv = cellSizeInv[0], dyInv = cellSizeInv[1], dzInv = cellSizeInv[2];
76 
77  const Box xbx = surroundingNodes(bx,0).grow(IntVect(0, 1, 1));
78  const Box ybx = surroundingNodes(bx,1).grow(IntVect(1, 0, 1));
79  const Box zbx = surroundingNodes(bx,2).grow(IntVect(1, 1, 0));
80 
81  ParallelFor(xbx, [=] AMREX_GPU_DEVICE (int i, int j, int k) noexcept
82  {
83  flx_arr[0](i,j,k,0) = rho_u(i,j,k) / mf_uy(i,j,0);
84  avg_xmom(i,j,k) = flx_arr[0](i,j,k,0);
85  });
86  ParallelFor(ybx, [=] AMREX_GPU_DEVICE (int i, int j, int k) noexcept
87  {
88  flx_arr[1](i,j,k,0) = rho_v(i,j,k) / mf_vx(i,j,0);
89  avg_ymom(i,j,k) = flx_arr[1](i,j,k,0);
90  });
91  ParallelFor(zbx, [=] AMREX_GPU_DEVICE (int i, int j, int k) noexcept
92  {
93  Real mfsq = mf_mx(i,j,0) * mf_my(i,j,0);
94  flx_arr[2](i,j,k,0) = Omega(i,j,k) / mfsq;
95  avg_zmom(i,j,k) = flx_arr[2](i,j,k,0);
96  });
97 
98  if (fixed_rho) {
99  ParallelFor(bx, [=] AMREX_GPU_DEVICE (int i, int j, int k) noexcept
100  {
101  advectionSrc(i,j,k,0) = zero;
102  });
103  } else
104  {
105  if (already_on_centroids) {
106 
107  ParallelFor(bx, [=] AMREX_GPU_DEVICE (int i, int j, int k) noexcept
108  {
109  if (detJ(i,j,k) > zero) {
110  Real mfsq = mf_mx(i,j,0) * mf_my(i,j,0);
111  advectionSrc(i,j,k,0) = - mfsq / detJ(i,j,k) * (
112  ( ax_arr(i+1,j,k) * flx_arr[0](i+1,j,k,0) - ax_arr(i,j,k) * flx_arr[0](i,j,k,0) ) * dxInv +
113  ( ay_arr(i,j+1,k) * flx_arr[1](i,j+1,k,0) - ay_arr(i,j,k) * flx_arr[1](i,j,k,0) ) * dyInv +
114  ( az_arr(i,j,k+1) * flx_arr[2](i,j,k+1,0) - az_arr(i,j,k) * flx_arr[2](i,j,k,0) ) * dzInv );
115  } else {
116  advectionSrc(i,j,k,0) = zero;
117  }
118  });
119 
120  } else {
121 
122  ParallelFor(bx, [=] AMREX_GPU_DEVICE (int i, int j, int k) noexcept
123  {
124  if (detJ(i,j,k) > zero) {
125  Real mfsq = mf_mx(i,j,0) * mf_my(i,j,0);
126  if (cfg_arr(i,j,k).isCovered())
127  {
128  advectionSrc(i,j,k,0) = zero;
129  }
130  else if (cfg_arr(i,j,k).isRegular())
131  {
132  advectionSrc(i,j,k,0) = - mfsq / detJ(i,j,k) * (
133  ( ax_arr(i+1,j,k) * flx_arr[0](i+1,j,k,0) - ax_arr(i,j,k) * flx_arr[0](i,j,k,0) ) * dxInv +
134  ( ay_arr(i,j+1,k) * flx_arr[1](i,j+1,k,0) - ay_arr(i,j,k) * flx_arr[1](i,j,k,0) ) * dyInv +
135  ( az_arr(i,j,k+1) * flx_arr[2](i,j,k+1,0) - az_arr(i,j,k) * flx_arr[2](i,j,k,0) ) * dzInv );
136  }
137  else
138  {
139  // Bilinear interpolation
140  Real fxm = flx_arr[0](i,j,k,0);
141  if (ax_arr(i,j,k) != zero && ax_arr(i,j,k) != one) {
142  int jj = j + static_cast<int>(std::copysign(one, fcx_arr(i,j,k,0)));
143  int kk = k + static_cast<int>(std::copysign(one, fcx_arr(i,j,k,1)));
144  Real fracy = (mask_arr(i-1,jj,k) || mask_arr(i,jj,k)) ? std::abs(fcx_arr(i,j,k,0)) : zero;
145  Real fracz = (mask_arr(i-1,j,kk) || mask_arr(i,j,kk)) ? std::abs(fcx_arr(i,j,k,1)) : zero;
146  fxm = (one-fracy)*(one-fracz)*fxm
147  + fracy *(one-fracz)*flx_arr[0](i,jj,k ,0)
148  + fracz *(one-fracy)*flx_arr[0](i,j ,kk,0)
149  + fracy * fracz *flx_arr[0](i,jj,kk,0);
150  }
151 
152  Real fxp = flx_arr[0](i+1,j,k,0);
153  if (ax_arr(i+1,j,k) != zero && ax_arr(i+1,j,k) != one) {
154  int jj = j + static_cast<int>(std::copysign(one,fcx_arr(i+1,j,k,0)));
155  int kk = k + static_cast<int>(std::copysign(one,fcx_arr(i+1,j,k,1)));
156  Real fracy = (mask_arr(i,jj,k) || mask_arr(i+1,jj,k)) ? std::abs(fcx_arr(i+1,j,k,0)) : zero;
157  Real fracz = (mask_arr(i,j,kk) || mask_arr(i+1,j,kk)) ? std::abs(fcx_arr(i+1,j,k,1)) : zero;
158  fxp = (one-fracy)*(one-fracz)*fxp
159  + fracy *(one-fracz)*flx_arr[0](i+1,jj,k ,0)
160  + fracz *(one-fracy)*flx_arr[0](i+1,j ,kk,0)
161  + fracy * fracz *flx_arr[0](i+1,jj,kk,0);
162  }
163 
164  Real fym = flx_arr[1](i,j,k,0);
165  if (ay_arr(i,j,k) != zero && ay_arr(i,j,k) != one) {
166  int ii = i + static_cast<int>(std::copysign(one,fcy_arr(i,j,k,0)));
167  int kk = k + static_cast<int>(std::copysign(one,fcy_arr(i,j,k,1)));
168  Real fracx = (mask_arr(ii,j-1,k) || mask_arr(ii,j,k)) ? std::abs(fcy_arr(i,j,k,0)) : zero;
169  Real fracz = (mask_arr(i,j-1,kk) || mask_arr(i,j,kk)) ? std::abs(fcy_arr(i,j,k,1)) : zero;
170  fym = (one-fracx)*(one-fracz)*fym
171  + fracx *(one-fracz)*flx_arr[1](ii,j,k ,0)
172  + fracz *(one-fracx)*flx_arr[1](i ,j,kk,0)
173  + fracx * fracz *flx_arr[1](ii,j,kk,0);
174  }
175 
176  Real fyp = flx_arr[1](i,j+1,k,0);
177  if (ay_arr(i,j+1,k) != zero && ay_arr(i,j+1,k) != one) {
178  int ii = i + static_cast<int>(std::copysign(one,fcy_arr(i,j+1,k,0)));
179  int kk = k + static_cast<int>(std::copysign(one,fcy_arr(i,j+1,k,1)));
180  Real fracx = (mask_arr(ii,j,k) || mask_arr(ii,j+1,k)) ? std::abs(fcy_arr(i,j+1,k,0)) : zero;
181  Real fracz = (mask_arr(i,j,kk) || mask_arr(i,j+1,kk)) ? std::abs(fcy_arr(i,j+1,k,1)) : zero;
182  fyp = (one-fracx)*(one-fracz)*fyp
183  + fracx *(one-fracz)*flx_arr[1](ii,j+1,k ,0)
184  + fracz *(one-fracx)*flx_arr[1](i ,j+1,kk,0)
185  + fracx * fracz *flx_arr[1](ii,j+1,kk,0);
186  }
187 
188  Real fzm = flx_arr[2](i,j,k,0);
189  if (az_arr(i,j,k) != zero && az_arr(i,j,k) != one) {
190  int ii = i + static_cast<int>(std::copysign(one,fcz_arr(i,j,k,0)));
191  int jj = j + static_cast<int>(std::copysign(one,fcz_arr(i,j,k,1)));
192  Real fracx = (mask_arr(ii,j,k-1) || mask_arr(ii,j,k)) ? std::abs(fcz_arr(i,j,k,0)) : zero;
193  Real fracy = (mask_arr(i,jj,k-1) || mask_arr(i,jj,k)) ? std::abs(fcz_arr(i,j,k,1)) : zero;
194  fzm = (one-fracx)*(one-fracy)*fzm
195  + fracx *(one-fracy)*flx_arr[2](ii,j ,k,0)
196  + fracy *(one-fracx)*flx_arr[2](i ,jj,k,0)
197  + fracx * fracy *flx_arr[2](ii,jj,k,0);
198  }
199 
200  Real fzp = flx_arr[2](i,j,k+1,0);
201  if (az_arr(i,j,k+1) != zero && az_arr(i,j,k+1) != one) {
202  int ii = i + static_cast<int>(std::copysign(one,fcz_arr(i,j,k+1,0)));
203  int jj = j + static_cast<int>(std::copysign(one,fcz_arr(i,j,k+1,1)));
204  Real fracx = (mask_arr(ii,j,k) || mask_arr(ii,j,k+1)) ? std::abs(fcz_arr(i,j,k+1,0)) : zero;
205  Real fracy = (mask_arr(i,jj,k) || mask_arr(i,jj,k+1)) ? std::abs(fcz_arr(i,j,k+1,1)) : zero;
206  fzp = (one-fracx)*(one-fracy)*fzp
207  + fracx *(one-fracy)*flx_arr[2](ii,j ,k+1,0)
208  + fracy *(one-fracx)*flx_arr[2](i ,jj,k+1,0)
209  + fracx * fracy *flx_arr[2](ii,jj,k+1,0);
210  }
211 
212  advectionSrc(i,j,k,0) = - mfsq / detJ(i,j,k) * (
213  ( ax_arr(i+1,j,k) * fxp - ax_arr(i,j,k) * fxm ) * dxInv +
214  ( ay_arr(i,j+1,k) * fyp - ay_arr(i,j,k) * fym ) * dyInv +
215  ( az_arr(i,j,k+1) * fzp - az_arr(i,j,k) * fzm ) * dzInv );
216  }
217  } else {
218  advectionSrc(i,j,k,0) = zero;
219  }
220  });
221 
222  } // already_on_centroids
223  } // fixed_rho
224 }
void EBAdvectionSrcForRho(const Box &bx, const Array4< Real > &advectionSrc, const Array4< const Real > &rho_u, const Array4< const Real > &rho_v, const Array4< const Real > &Omega, const Array4< Real > &avg_xmom, const Array4< Real > &avg_ymom, const Array4< Real > &avg_zmom, const Array4< const int > &mask_arr, const Array4< const EBCellFlag > &cfg_arr, const Array4< const Real > &ax_arr, const Array4< const Real > &ay_arr, const Array4< const Real > &az_arr, const Array4< const Real > &fcx_arr, const Array4< const Real > &fcy_arr, const Array4< const Real > &fcz_arr, const Array4< const Real > &detJ, const GpuArray< Real, AMREX_SPACEDIM > &cellSizeInv, const Array4< const Real > &mf_mx, const Array4< const Real > &mf_my, const Array4< const Real > &mf_uy, const Array4< const Real > &mf_vx, const GpuArray< const Array4< Real >, AMREX_SPACEDIM > &flx_arr, const bool fixed_rho, bool already_on_centroids)
Compute the EB advective tendency for rho and rho theta.
Definition: ERF_EBAdvectionSrcForState.cpp:48
amrex::GpuArray< Real, AMREX_SPACEDIM > dxInv
Definition: ERF_InitCustomPertVels_ParticleTests.H:17
ParallelFor(fab_box, [=] AMREX_GPU_DEVICE(int i, int j, int k) { qrcuten_arr(i, j, k)=Real(0);qscuten_arr(i, j, k)=Real(0);qicuten_arr(i, j, k)=Real(0);})
constexpr amrex::Real one
Definition: ERF_NumericalConstants.H:30
constexpr amrex::Real zero
Definition: ERF_NumericalConstants.H:29
amrex::Real Real
Definition: ERF_ShocInterface.H:19
Here is the call graph for this function:

◆ EBAdvectionSrcForScalars()

void EBAdvectionSrcForScalars ( const Box &  bx,
const int  icomp,
const int  ncomp,
const Array4< const Real > &  avg_xmom,
const Array4< const Real > &  avg_ymom,
const Array4< const Real > &  avg_zmom,
const Array4< const Real > &  cell_prim,
const Array4< Real > &  advectionSrc,
const Array4< const int > &  mask_arr,
const Array4< const EBCellFlag > &  cfg_arr,
const Array4< const Real > &  ax_arr,
const Array4< const Real > &  ay_arr,
const Array4< const Real > &  az_arr,
const Array4< const Real > &  fcx_arr,
const Array4< const Real > &  fcy_arr,
const Array4< const Real > &  fcz_arr,
const Array4< const Real > &  detJ,
const GpuArray< Real, AMREX_SPACEDIM > &  cellSizeInv,
const Array4< const Real > &  mf_mx,
const Array4< const Real > &  mf_my,
const AdvType  horiz_adv_type,
const AdvType  vert_adv_type,
const Real  horiz_upw_frac,
const Real  vert_upw_frac,
const GpuArray< const Array4< Real >, AMREX_SPACEDIM > &  flx_arr,
const Box &  domain,
const BCRec *  bc_ptr_h,
bool  already_on_centroids 
)

Compute the EB advective tendency for scalars.

Parameters
[in]bxBox over which the scalars are updated.
[in]icompComponent of the first scalar to update.
[in]ncompNumber of scalar components to update.
[in]avg_xmomx-face momentum average from EBAdvectionSrcForRho.
[in]avg_ymomy-face momentum average from EBAdvectionSrcForRho.
[in]avg_zmomz-face momentum average from EBAdvectionSrcForRho.
[in]cell_primPrimitive scalar variables.
[out]advectionSrcTendency for the scalar update equation.
[in]mask_arrCell-centered mask used for EB face interpolation.
[in]cfg_arrCell-centered EB flags.
[in]ax_arrArea fraction on x-faces.
[in]ay_arrArea fraction on y-faces.
[in]az_arrArea fraction on z-faces.
[in]fcx_arrFace centroid on x-faces.
[in]fcy_arrFace centroid on y-faces.
[in]fcz_arrFace centroid on z-faces.
[in]detJJacobian of the metric transformation.
[in]cellSizeInvInverse grid spacing.
[in]mf_mxx-direction map factor at cell centers.
[in]mf_myy-direction map factor at cell centers.
[in]horiz_adv_typeHorizontal advection scheme.
[in]vert_adv_typeVertical advection scheme.
[in]horiz_upw_fracHorizontal upwinding fraction for blended schemes.
[in]vert_upw_fracVertical upwinding fraction for blended schemes.
[out]flx_arrDirectional flux arrays.
[in]domainProblem-domain box used to detect open boundaries.
[in]bc_ptr_hBoundary conditions for conserved components.
[in]already_on_centroidsWhether EB geometric data are already centroid-adjusted.
288 {
289  BL_PROFILE_VAR("EBAdvectionSrcForScalars", EBAdvectionSrcForScalars);
290  auto dxInv = cellSizeInv[0], dyInv = cellSizeInv[1], dzInv = cellSizeInv[2];
291 
292  const Box xbx = surroundingNodes(bx,0).grow(IntVect(0, 1, 1));
293  const Box ybx = surroundingNodes(bx,1).grow(IntVect(1, 0, 1));
294  const Box zbx = surroundingNodes(bx,2).grow(IntVect(1, 1, 0));
295 
296  // Open bc will be imposed upon all vars (we only access cons here for simplicity)
297  const bool xlo_open = (bc_ptr_h[BCVars::cons_bc].lo(0) == ERFBCType::open);
298  const bool xhi_open = (bc_ptr_h[BCVars::cons_bc].hi(0) == ERFBCType::open);
299  const bool ylo_open = (bc_ptr_h[BCVars::cons_bc].lo(1) == ERFBCType::open);
300  const bool yhi_open = (bc_ptr_h[BCVars::cons_bc].hi(1) == ERFBCType::open);
301 
302  // Inline with 2nd order for efficiency
303  // NOTE: For EB, avg_xmom, avg_ymom, avg_zmom were are weighted by area fractions in AdvectionSrcForRho
304  // The flux is weighted by area fraction after its interpolation.
305  if (horiz_adv_type == AdvType::Centered_2nd && vert_adv_type == AdvType::Centered_2nd)
306  {
307  ParallelFor(xbx, ncomp,[=] AMREX_GPU_DEVICE (int i, int j, int k, int n) noexcept
308  {
309  const int cons_index = icomp + n;
310  const int prim_index = cons_index - 1;
311  const Real prim_on_face = myhalf * (cell_prim(i,j,k,prim_index) + cell_prim(i-1,j,k,prim_index));
312  flx_arr[0](i,j,k,cons_index) = avg_xmom(i,j,k) * prim_on_face;
313  });
314  ParallelFor(ybx, ncomp,[=] AMREX_GPU_DEVICE (int i, int j, int k, int n) noexcept
315  {
316  const int cons_index = icomp + n;
317  const int prim_index = cons_index - 1;
318  const Real prim_on_face = myhalf * (cell_prim(i,j,k,prim_index) + cell_prim(i,j-1,k,prim_index));
319  flx_arr[1](i,j,k,cons_index) = avg_ymom(i,j,k) * prim_on_face;
320  });
321  ParallelFor(zbx, ncomp,[=] AMREX_GPU_DEVICE (int i, int j, int k, int n) noexcept
322  {
323  const int cons_index = icomp + n;
324  const int prim_index = cons_index - 1;
325  const Real prim_on_face = myhalf * (cell_prim(i,j,k,prim_index) + cell_prim(i,j,k-1,prim_index));
326  flx_arr[2](i,j,k,cons_index) = avg_zmom(i,j,k) * prim_on_face;
327  });
328 
329  // Template higher order methods (horizontal first)
330  } else {
331  switch(horiz_adv_type) {
333  EBAdvectionSrcForScalarsVert<CENTERED2>(bx, ncomp, icomp, flx_arr, cell_prim,
334  avg_xmom, avg_ymom, avg_zmom, cfg_arr, ax_arr, ay_arr, az_arr,
335  horiz_upw_frac, vert_upw_frac, vert_adv_type);
336  break;
337  case AdvType::Upwind_3rd:
338  EBAdvectionSrcForScalarsVert<UPWIND3>(bx, ncomp, icomp, flx_arr, cell_prim,
339  avg_xmom, avg_ymom, avg_zmom, cfg_arr, ax_arr, ay_arr, az_arr,
340  horiz_upw_frac, vert_upw_frac, vert_adv_type);
341  break;
343  EBAdvectionSrcForScalarsVert<CENTERED4>(bx, ncomp, icomp, flx_arr, cell_prim,
344  avg_xmom, avg_ymom, avg_zmom, cfg_arr, ax_arr, ay_arr, az_arr,
345  horiz_upw_frac, vert_upw_frac, vert_adv_type);
346  break;
347  case AdvType::Upwind_5th:
348  EBAdvectionSrcForScalarsVert<UPWIND5>(bx, ncomp, icomp, flx_arr, cell_prim,
349  avg_xmom, avg_ymom, avg_zmom, cfg_arr, ax_arr, ay_arr, az_arr,
350  horiz_upw_frac, vert_upw_frac, vert_adv_type);
351  break;
353  EBAdvectionSrcForScalarsVert<CENTERED6>(bx, ncomp, icomp, flx_arr, cell_prim,
354  avg_xmom, avg_ymom, avg_zmom, cfg_arr, ax_arr, ay_arr, az_arr,
355  horiz_upw_frac, vert_upw_frac, vert_adv_type);
356  break;
357  default:
358  AMREX_ASSERT_WITH_MESSAGE(false, "Unknown advection scheme! WENO is currently not supported for EB.");
359  }
360  }
361 
362  // Compute divergence
363 
364  if (already_on_centroids) {
365 
366  ParallelFor(bx, ncomp, [=] AMREX_GPU_DEVICE (int i, int j, int k, int n) noexcept
367  {
368  const int cons_index = icomp + n;
369  if (detJ(i,j,k) > zero)
370  {
371  Real invdetJ = one / detJ(i,j,k);
372  Real mfsq = mf_mx(i,j,0) * mf_my(i,j,0);
373 
374  advectionSrc(i,j,k,cons_index) = - invdetJ * mfsq * (
375  ( ax_arr(i+1,j,k) * flx_arr[0](i+1,j,k,cons_index) - ax_arr(i,j,k) * flx_arr[0](i ,j,k,cons_index) ) * dxInv +
376  ( ay_arr(i,j+1,k) * flx_arr[1](i,j+1,k,cons_index) - ay_arr(i,j,k) * flx_arr[1](i,j ,k,cons_index) ) * dyInv +
377  ( az_arr(i,j,k+1) * flx_arr[2](i,j,k+1,cons_index) - az_arr(i,j,k) * flx_arr[2](i,j,k ,cons_index) ) * dzInv );
378  } else {
379  advectionSrc(i,j,k,cons_index) = zero;
380  }
381  });
382 
383  } else {
384 
385  AMREX_HOST_DEVICE_FOR_4D(bx,ncomp,i,j,k,n,
386  {
387  const int cons_index = icomp + n;
388  if (detJ(i,j,k) > zero)
389  {
390  Real invdetJ = one / detJ(i,j,k);
391  Real mfsq = mf_mx(i,j,0) * mf_my(i,j,0);
392  if (cfg_arr(i,j,k).isCovered())
393  {
394  advectionSrc(i,j,k,cons_index) = zero;
395  }
396  else if (cfg_arr(i,j,k).isRegular())
397  {
398  advectionSrc(i,j,k,cons_index) = - invdetJ * mfsq * (
399  ( ax_arr(i+1,j,k) * flx_arr[0](i+1,j,k,cons_index) - ax_arr(i,j,k) * flx_arr[0](i ,j,k,cons_index) ) * dxInv +
400  ( ay_arr(i,j+1,k) * flx_arr[1](i,j+1,k,cons_index) - ay_arr(i,j,k) * flx_arr[1](i,j ,k,cons_index) ) * dyInv +
401  ( az_arr(i,j,k+1) * flx_arr[2](i,j,k+1,cons_index) - az_arr(i,j,k) * flx_arr[2](i,j,k ,cons_index) ) * dzInv );
402  }
403  else
404  {
405  // Bilinear interpolation
406  Real fxm = flx_arr[0](i,j,k,cons_index);
407  if (ax_arr(i,j,k) != zero && ax_arr(i,j,k) != one) {
408  int jj = j + static_cast<int>(std::copysign(one, fcx_arr(i,j,k,0)));
409  int kk = k + static_cast<int>(std::copysign(one, fcx_arr(i,j,k,1)));
410  Real fracy = (mask_arr(i-1,jj,k) || mask_arr(i,jj,k)) ? std::abs(fcx_arr(i,j,k,0)) : zero;
411  Real fracz = (mask_arr(i-1,j,kk) || mask_arr(i,j,kk)) ? std::abs(fcx_arr(i,j,k,1)) : zero;
412  fxm = (one-fracy)*(one-fracz)*fxm
413  + fracy *(one-fracz)*flx_arr[0](i,jj,k ,cons_index)
414  + fracz *(one-fracy)*flx_arr[0](i,j ,kk,cons_index)
415  + fracy * fracz *flx_arr[0](i,jj,kk,cons_index);
416  }
417 
418  Real fxp = flx_arr[0](i+1,j,k,cons_index);
419  if (ax_arr(i+1,j,k) != zero && ax_arr(i+1,j,k) != one) {
420  int jj = j + static_cast<int>(std::copysign(one,fcx_arr(i+1,j,k,0)));
421  int kk = k + static_cast<int>(std::copysign(one,fcx_arr(i+1,j,k,1)));
422  Real fracy = (mask_arr(i,jj,k) || mask_arr(i+1,jj,k)) ? std::abs(fcx_arr(i+1,j,k,0)) : zero;
423  Real fracz = (mask_arr(i,j,kk) || mask_arr(i+1,j,kk)) ? std::abs(fcx_arr(i+1,j,k,1)) : zero;
424  fxp = (one-fracy)*(one-fracz)*fxp
425  + fracy *(one-fracz)*flx_arr[0](i+1,jj,k ,cons_index)
426  + fracz *(one-fracy)*flx_arr[0](i+1,j ,kk,cons_index)
427  + fracy * fracz *flx_arr[0](i+1,jj,kk,cons_index);
428  }
429 
430  Real fym = flx_arr[1](i,j,k,cons_index);
431  if (ay_arr(i,j,k) != zero && ay_arr(i,j,k) != one) {
432  int ii = i + static_cast<int>(std::copysign(one,fcy_arr(i,j,k,0)));
433  int kk = k + static_cast<int>(std::copysign(one,fcy_arr(i,j,k,1)));
434  Real fracx = (mask_arr(ii,j-1,k) || mask_arr(ii,j,k)) ? std::abs(fcy_arr(i,j,k,0)) : zero;
435  Real fracz = (mask_arr(i,j-1,kk) || mask_arr(i,j,kk)) ? std::abs(fcy_arr(i,j,k,1)) : zero;
436  fym = (one-fracx)*(one-fracz)*fym
437  + fracx *(one-fracz)*flx_arr[1](ii,j,k ,cons_index)
438  + fracz *(one-fracx)*flx_arr[1](i ,j,kk,cons_index)
439  + fracx * fracz *flx_arr[1](ii,j,kk,cons_index);
440  }
441 
442  Real fyp = flx_arr[1](i,j+1,k,cons_index);
443  if (ay_arr(i,j+1,k) != zero && ay_arr(i,j+1,k) != one) {
444  int ii = i + static_cast<int>(std::copysign(one,fcy_arr(i,j+1,k,0)));
445  int kk = k + static_cast<int>(std::copysign(one,fcy_arr(i,j+1,k,1)));
446  Real fracx = (mask_arr(ii,j,k) || mask_arr(ii,j+1,k)) ? std::abs(fcy_arr(i,j+1,k,0)) : zero;
447  Real fracz = (mask_arr(i,j,kk) || mask_arr(i,j+1,kk)) ? std::abs(fcy_arr(i,j+1,k,1)) : zero;
448  fyp = (one-fracx)*(one-fracz)*fyp
449  + fracx *(one-fracz)*flx_arr[1](ii,j+1,k ,cons_index)
450  + fracz *(one-fracx)*flx_arr[1](i ,j+1,kk,cons_index)
451  + fracx * fracz *flx_arr[1](ii,j+1,kk,cons_index);
452  }
453 
454  Real fzm = flx_arr[2](i,j,k,cons_index);
455  if (az_arr(i,j,k) != zero && az_arr(i,j,k) != one) {
456  int ii = i + static_cast<int>(std::copysign(one,fcz_arr(i,j,k,0)));
457  int jj = j + static_cast<int>(std::copysign(one,fcz_arr(i,j,k,1)));
458  Real fracx = (mask_arr(ii,j,k-1) || mask_arr(ii,j,k)) ? std::abs(fcz_arr(i,j,k,0)) : zero;
459  Real fracy = (mask_arr(i,jj,k-1) || mask_arr(i,jj,k)) ? std::abs(fcz_arr(i,j,k,1)) : zero;
460  fzm = (one-fracx)*(one-fracy)*fzm
461  + fracx *(one-fracy)*flx_arr[2](ii,j ,k,cons_index)
462  + fracy *(one-fracx)*flx_arr[2](i ,jj,k,cons_index)
463  + fracx * fracy *flx_arr[2](ii,jj,k,cons_index);
464  }
465 
466  Real fzp = flx_arr[2](i,j,k+1,cons_index);
467  if (az_arr(i,j,k+1) != zero && az_arr(i,j,k+1) != one) {
468  int ii = i + static_cast<int>(std::copysign(one,fcz_arr(i,j,k+1,0)));
469  int jj = j + static_cast<int>(std::copysign(one,fcz_arr(i,j,k+1,1)));
470  Real fracx = (mask_arr(ii,j,k) || mask_arr(ii,j,k+1)) ? std::abs(fcz_arr(i,j,k+1,0)) : zero;
471  Real fracy = (mask_arr(i,jj,k) || mask_arr(i,jj,k+1)) ? std::abs(fcz_arr(i,j,k+1,1)) : zero;
472  fzp = (one-fracx)*(one-fracy)*fzp
473  + fracx *(one-fracy)*flx_arr[2](ii,j ,k+1,cons_index)
474  + fracy *(one-fracx)*flx_arr[2](i ,jj,k+1,cons_index)
475  + fracx * fracy *flx_arr[2](ii,jj,k+1,cons_index);
476  }
477 
478  advectionSrc(i,j,k,cons_index) = - invdetJ * mfsq * (
479  ( ax_arr(i+1,j,k) * fxp - ax_arr(i,j,k) * fxm ) * dxInv
480  + ( ay_arr(i,j+1,k) * fyp - ay_arr(i,j,k) * fym ) * dyInv
481  + ( az_arr(i,j,k+1) * fzp - az_arr(i,j,k) * fzm ) * dzInv );
482  }
483 
484  // eb_compute_divergence(i,j,k,n,advectionSrc,AMREX_D_DECL(flx_arr[0],flx_arr[1],flx_arr[2]),
485  // mask_arr, cfg_arr, detJ, AMREX_D_DECL(ax_arr,ay_arr,az_arr),
486  // AMREX_D_DECL(fcx_arr,fcy_arr,fcz_arr), cellSizeInv, already_on_centroids);
487 
488 
489  } else {
490  advectionSrc(i,j,k,cons_index) = zero;
491  }
492  });
493 
494  }
495 
496  // Special advection operator for open BC (bndry tangent operations)
497  //
498  // The state is tangent to every lateral boundary, so where two perpendicular open
499  // boundaries meet there is no boundary-normal operator to own the corner cell.
500  // These kernels assign rather than accumulate, so the corner must appear in
501  // exactly one patch: OpenBCTangentPatches gives the four edges trimmed clear of
502  // the corners, plus the corners tagged with both open sides so that the kernel
503  // differences across neither open boundary there.
504  for (const OpenBCPatch& patch : OpenBCTangentPatches(bx, domain,
505  xlo_open, xhi_open, ylo_open, yhi_open))
506  {
507  AdvectionSrcForOpenBC_Tangent_Cons(patch.box, patch.x_side, patch.y_side,
508  icomp, ncomp, advectionSrc, cell_prim,
509  avg_xmom, avg_ymom, avg_zmom,
510  detJ, cellSizeInv);
511  }
512 }
amrex::Vector< OpenBCPatch > OpenBCTangentPatches(const amrex::Box &b, const amrex::Box &domain, const bool xlo_open, const bool xhi_open, const bool ylo_open, const bool yhi_open)
Definition: ERF_Advection.H:291
void AdvectionSrcForOpenBC_Tangent_Cons(const amrex::Box &bx, const OpenSide x_side, const OpenSide y_side, const int &icomp, const int &ncomp, const amrex::Array4< amrex::Real > &cell_rhs, const amrex::Array4< const amrex::Real > &cell_prim, const amrex::Array4< const amrex::Real > &avg_xmom, const amrex::Array4< const amrex::Real > &avg_ymom, const amrex::Array4< const amrex::Real > &avg_zmom, const amrex::Array4< const amrex::Real > &detJ, const amrex::GpuArray< amrex::Real, AMREX_SPACEDIM > &cellSizeInv)
void EBAdvectionSrcForScalars(const Box &bx, const int icomp, const int ncomp, const Array4< const Real > &avg_xmom, const Array4< const Real > &avg_ymom, const Array4< const Real > &avg_zmom, const Array4< const Real > &cell_prim, const Array4< Real > &advectionSrc, const Array4< const int > &mask_arr, const Array4< const EBCellFlag > &cfg_arr, const Array4< const Real > &ax_arr, const Array4< const Real > &ay_arr, const Array4< const Real > &az_arr, const Array4< const Real > &fcx_arr, const Array4< const Real > &fcy_arr, const Array4< const Real > &fcz_arr, const Array4< const Real > &detJ, const GpuArray< Real, AMREX_SPACEDIM > &cellSizeInv, const Array4< const Real > &mf_mx, const Array4< const Real > &mf_my, const AdvType horiz_adv_type, const AdvType vert_adv_type, const Real horiz_upw_frac, const Real vert_upw_frac, const GpuArray< const Array4< Real >, AMREX_SPACEDIM > &flx_arr, const Box &domain, const BCRec *bc_ptr_h, bool already_on_centroids)
Compute the EB advective tendency for scalars.
Definition: ERF_EBAdvectionSrcForState.cpp:260
@ Centered_4th
@ Centered_6th
@ Centered_2nd
constexpr amrex::Real myhalf
Definition: ERF_NumericalConstants.H:34
AMREX_ASSERT_WITH_MESSAGE(wbar_cutoff_min > wbar_cutoff_max, "ERROR: wbar_cutoff_min < wbar_cutoff_max")
@ cons_bc
Definition: ERF_IndexDefines.H:89
@ open
Definition: ERF_IndexDefines.H:304
Definition: ERF_Advection.H:217
Here is the call graph for this function: