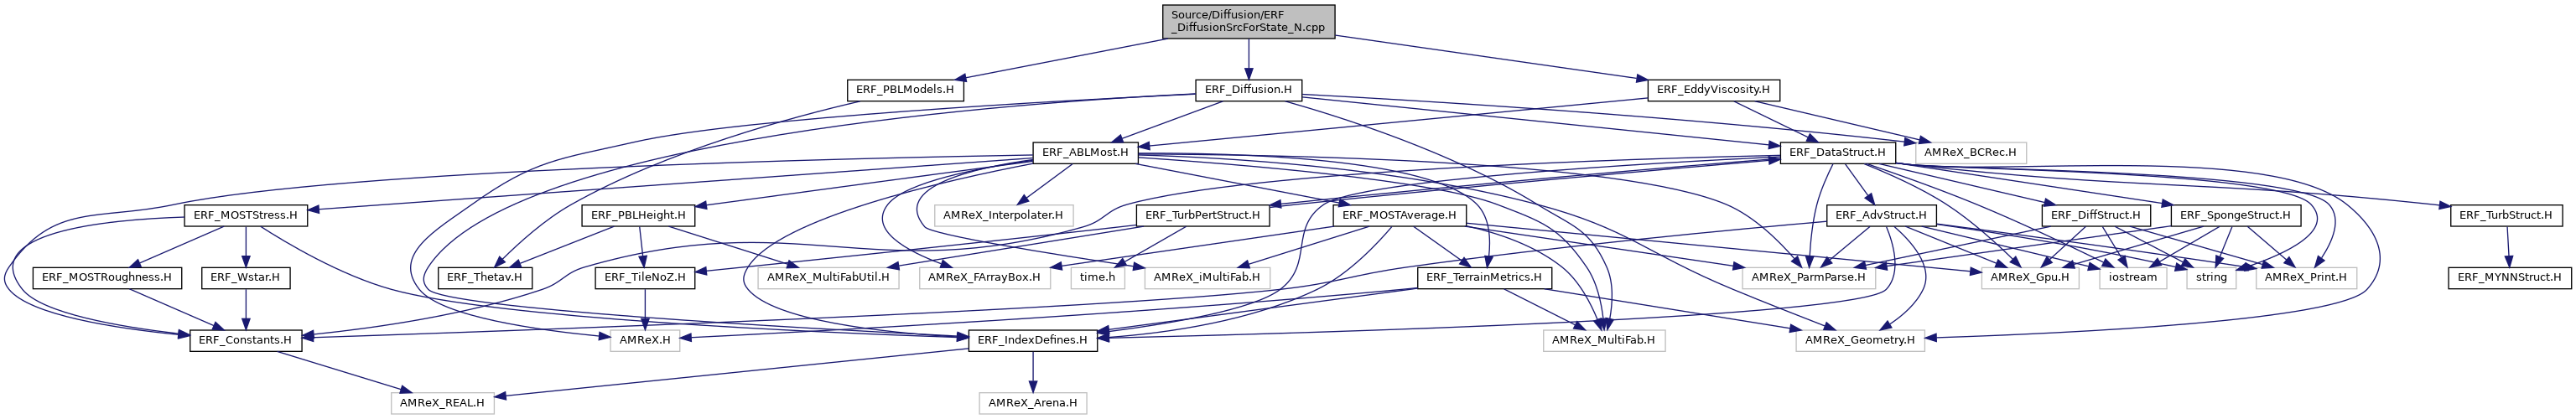
Function for computing the scalar RHS for diffusion operator without terrain.
82 const Real explicit_fac =
one - implicit_fac;
85 Real l_abs_g = std::abs(grav_gpu[2]);
87 const Real dz_inv = cellSizeInv[2];
89 for (
int n(0); n<num_comp; ++n) {
90 const int qty_index = start_comp + n;
93 if (l_consA && l_turb) {
94 ParallelFor(xbx, [=] AMREX_GPU_DEVICE (
int i,
int j,
int k) noexcept
96 const int prim_index = qty_index - 1;
100 Real rhoAlpha = rhoFace * d_alpha_eff[prim_scal_index];
101 rhoAlpha +=
myhalf * ( mu_turb(i , j, k, d_eddy_diff_idx[prim_scal_index])
102 + mu_turb(i-1, j, k, d_eddy_diff_idx[prim_scal_index]) );
111 ext_dir_on_xlo &= (i == dom_lo.x);
116 ext_dir_on_xhi &= (i == dom_hi.x+1);
117 bool SurfLayer_on_xlo = ( SurfLayer_xlo && i == dom_lo.x);
118 bool SurfLayer_on_xhi = ( SurfLayer_xhi && i == dom_hi.x + 1);
120 if (ext_dir_on_xlo) {
121 xflux(i,j,k) = -rhoAlpha * ( -(
Real(8.)/
three) * cell_prim(i-1, j, k, prim_index)
122 +
three * cell_prim(i , j, k, prim_index)
123 - (
one/
three) * cell_prim(i+1, j, k, prim_index) ) * dx_inv * mf_ux(i,j,0)/mf_uy(i,j,0);
124 }
else if (ext_dir_on_xhi) {
125 xflux(i,j,k) = -rhoAlpha * ( (
Real(8.)/
three) * cell_prim(i , j, k, prim_index)
126 -
three * cell_prim(i-1, j, k, prim_index)
127 + (
one/
three) * cell_prim(i-2, j, k, prim_index) ) * dx_inv * mf_ux(i,j,0)/mf_uy(i,j,0);
128 }
else if ((SurfLayer_on_xlo || SurfLayer_on_xhi) && (qty_index ==
RhoTheta_comp)) {
129 xflux(i,j,k) = hfx_x(i,j,k);
130 }
else if ((SurfLayer_on_xlo || SurfLayer_on_xhi) && (qty_index ==
RhoQ1_comp)) {
131 xflux(i,j,k) = qfx1_x(i,j,k);
133 xflux(i,j,k) = -rhoAlpha * ( cell_prim(i , j, k, prim_index)
134 - cell_prim(i-1, j, k, prim_index) ) * dx_inv * mf_ux(i,j,0)/mf_uy(i,j,0);
138 ParallelFor(ybx, [=] AMREX_GPU_DEVICE (
int i,
int j,
int k) noexcept
140 const int prim_index = qty_index - 1;
144 Real rhoAlpha = rhoFace * d_alpha_eff[prim_scal_index];
145 rhoAlpha +=
myhalf * ( mu_turb(i, j , k, d_eddy_diff_idy[prim_scal_index])
146 + mu_turb(i, j-1, k, d_eddy_diff_idy[prim_scal_index]) );
154 ext_dir_on_ylo &= (j == dom_lo.y);
158 ext_dir_on_yhi &= (j == dom_hi.y+1);
160 bool SurfLayer_on_ylo = ( SurfLayer_ylo && j == dom_lo.y);
161 bool SurfLayer_on_yhi = ( SurfLayer_yhi && j == dom_hi.y + 1);
162 if (ext_dir_on_ylo) {
163 yflux(i,j,k) = -rhoAlpha * ( -(
Real(8.)/
three) * cell_prim(i, j-1, k, prim_index)
164 +
three * cell_prim(i, j , k, prim_index)
165 - (
one/
three) * cell_prim(i, j+1, k, prim_index) ) * dy_inv * mf_vy(i,j,0)/mf_vx(i,j,0);
166 }
else if (ext_dir_on_yhi) {
167 yflux(i,j,k) = -rhoAlpha * ( (
Real(8.)/
three) * cell_prim(i, j , k, prim_index)
168 -
three * cell_prim(i, j-1, k, prim_index)
169 + (
one/
three) * cell_prim(i, j-2, k, prim_index) ) * dy_inv * mf_vy(i,j,0)/mf_vx(i,j,0);
170 }
else if ((SurfLayer_on_ylo || SurfLayer_on_yhi) && (qty_index ==
RhoTheta_comp)) {
171 yflux(i,j,k) = hfx_y(i,j,k);
172 }
else if ((SurfLayer_on_ylo || SurfLayer_on_yhi) && (qty_index ==
RhoQ1_comp)) {
173 yflux(i,j,k) = qfx1_y(i,j,k);
175 yflux(i,j,k) = -rhoAlpha * (cell_prim(i, j, k, prim_index) - cell_prim(i, j-1, k, prim_index)) * dy_inv * mf_vy(i,j,0)/mf_vx(i,j,0);
179 ParallelFor(zbx, [=] AMREX_GPU_DEVICE (
int i,
int j,
int k) noexcept
181 const int prim_index = qty_index - 1;
185 Real rhoAlpha = rhoFace * d_alpha_eff[prim_scal_index];
186 rhoAlpha +=
myhalf * ( mu_turb(i, j, k , d_eddy_diff_idz[prim_scal_index])
187 + mu_turb(i, j, k-1, d_eddy_diff_idz[prim_scal_index]) );
199 bool SurfLayer_on_zlo = ( SurfLayer_zlo && k == dom_lo.z);
200 bool SurfLayer_on_zhi = ( SurfLayer_zhi && k == dom_hi.z + 1);
202 if (ext_dir_on_zlo) {
203 zflux(i,j,k) = -rhoAlpha * ( -(
Real(8.)/
three) * cell_prim(i, j, k-1, prim_index)
204 +
three * cell_prim(i, j, k , prim_index)
205 - (
one/
three) * cell_prim(i, j, k+1, prim_index) ) * dz_inv;
206 }
else if (ext_dir_on_zhi) {
207 zflux(i,j,k) = -rhoAlpha * ( (
Real(8.)/
three) * cell_prim(i, j, k , prim_index)
208 -
three * cell_prim(i, j, k-1, prim_index)
209 + (
one/
three) * cell_prim(i, j, k-2, prim_index) ) * dz_inv;
210 }
else if (SurfLayer_on_zlo || SurfLayer_on_zhi) {
212 zflux(i,j,k) = hfx_z(i,j,k);
214 zflux(i,j,k) = qfx1_z(i,j,k);
219 zflux(i,j,k) = -rhoAlpha * (cell_prim(i, j, k, prim_index) - cell_prim(i, j, k-1, prim_index)) * dz_inv;
223 if (!(SurfLayer_on_zlo || SurfLayer_on_zhi)) {
224 hfx_z(i,j,k) = zflux(i,j,k);
227 if (!(SurfLayer_on_zlo || SurfLayer_on_zhi)) {
228 qfx1_z(i,j,k) = zflux(i,j,k);
231 qfx2_z(i,j,k) = zflux(i,j,k);
236 ParallelFor(xbx, [=] AMREX_GPU_DEVICE (
int i,
int j,
int k) noexcept
238 const int prim_index = qty_index - 1;
240 Real rhoAlpha = d_alpha_eff[prim_index];
241 rhoAlpha +=
myhalf * ( mu_turb(i , j, k, d_eddy_diff_idx[prim_index])
242 + mu_turb(i-1, j, k, d_eddy_diff_idx[prim_index]) );
251 ext_dir_on_xlo &= (i == dom_lo.x);
256 ext_dir_on_xhi &= (i == dom_hi.x+1);
258 bool SurfLayer_on_xlo = ( SurfLayer_xlo && i == dom_lo.x);
259 bool SurfLayer_on_xhi = ( SurfLayer_xhi && i == dom_hi.x + 1);
260 if (ext_dir_on_xlo) {
261 xflux(i,j,k) = -rhoAlpha * ( -(
Real(8.)/
three) * cell_prim(i-1, j, k, prim_index)
262 +
three * cell_prim(i , j, k, prim_index)
263 - (
one/
three) * cell_prim(i+1, j, k, prim_index) ) * dx_inv * mf_ux(i,j,0)/mf_uy(i,j,0);
264 }
else if (ext_dir_on_xhi) {
265 xflux(i,j,k) = -rhoAlpha * ( (
Real(8.)/
three) * cell_prim(i , j, k, prim_index)
266 -
three * cell_prim(i-1, j, k, prim_index)
267 + (
one/
three) * cell_prim(i-2, j, k, prim_index) ) * dx_inv * mf_ux(i,j,0)/mf_uy(i,j,0);
268 }
else if ((SurfLayer_on_xlo || SurfLayer_on_xhi) && (qty_index ==
RhoTheta_comp)) {
269 xflux(i,j,k) = hfx_x(i,j,k);
270 }
else if ((SurfLayer_on_xlo || SurfLayer_on_xhi) && (qty_index ==
RhoQ1_comp)) {
271 xflux(i,j,k) = qfx1_x(i,j,k);
273 xflux(i,j,k) = -rhoAlpha * ( cell_prim(i , j, k, prim_index)
274 - cell_prim(i-1, j, k, prim_index) ) * dx_inv * mf_ux(i,j,0)/mf_uy(i,j,0);
278 ParallelFor(ybx, [=] AMREX_GPU_DEVICE (
int i,
int j,
int k) noexcept
280 const int prim_index = qty_index - 1;
282 Real rhoAlpha = d_alpha_eff[prim_index];
283 rhoAlpha +=
myhalf * ( mu_turb(i, j , k, d_eddy_diff_idy[prim_index])
284 + mu_turb(i, j-1, k, d_eddy_diff_idy[prim_index]) );
293 ext_dir_on_ylo &= (j == dom_lo.y);
298 ext_dir_on_yhi &= (j == dom_hi.y+1);
300 bool SurfLayer_on_ylo = ( SurfLayer_ylo && j == dom_lo.y);
301 bool SurfLayer_on_yhi = ( SurfLayer_yhi && j == dom_hi.y + 1);
302 if (ext_dir_on_ylo) {
303 yflux(i,j,k) = -rhoAlpha * ( -(
Real(8.)/
three) * cell_prim(i, j-1, k, prim_index)
304 +
three * cell_prim(i, j , k, prim_index)
305 - (
one/
three) * cell_prim(i, j+1, k, prim_index) ) * dy_inv * mf_vy(i,j,0)/mf_vx(i,j,0);
306 }
else if (ext_dir_on_yhi) {
307 yflux(i,j,k) = -rhoAlpha * ( (
Real(8.)/
three) * cell_prim(i, j , k, prim_index)
308 -
three * cell_prim(i, j-1, k, prim_index)
309 + (
one/
three) * cell_prim(i, j-2, k, prim_index) ) * dy_inv * mf_vy(i,j,0)/mf_vx(i,j,0);
310 }
else if ((SurfLayer_on_ylo || SurfLayer_on_yhi) && (qty_index ==
RhoTheta_comp)) {
311 yflux(i,j,k) = hfx_y(i,j,k);
312 }
else if ((SurfLayer_on_ylo || SurfLayer_on_yhi) && (qty_index ==
RhoQ1_comp)) {
313 yflux(i,j,k) = qfx1_y(i,j,k);
315 yflux(i,j,k) = -rhoAlpha * (cell_prim(i, j, k, prim_index) - cell_prim(i, j-1, k, prim_index)) * dy_inv * mf_vy(i,j,0)/mf_vx(i,j,0);
319 ParallelFor(zbx, [=] AMREX_GPU_DEVICE (
int i,
int j,
int k) noexcept
321 const int prim_index = qty_index - 1;
323 Real rhoAlpha = d_alpha_eff[prim_index];
324 rhoAlpha +=
myhalf * ( mu_turb(i, j, k , d_eddy_diff_idz[prim_index])
325 + mu_turb(i, j, k-1, d_eddy_diff_idz[prim_index]) );
336 bool SurfLayer_on_zlo = ( SurfLayer_zlo && k == dom_lo.z);
337 bool SurfLayer_on_zhi = ( SurfLayer_zhi && k == dom_hi.z + 1);
339 if (ext_dir_on_zlo) {
340 zflux(i,j,k) = -rhoAlpha * ( -(
Real(8.)/
three) * cell_prim(i, j, k-1, prim_index)
341 +
three * cell_prim(i, j, k , prim_index)
342 - (
one/
three) * cell_prim(i, j, k+1, prim_index) ) * dz_inv;
343 }
else if (ext_dir_on_zhi) {
344 zflux(i,j,k) = -rhoAlpha * ( (
Real(8.)/
three) * cell_prim(i, j, k , prim_index)
345 -
three * cell_prim(i, j, k-1, prim_index)
346 + (
one/
three) * cell_prim(i, j, k-2, prim_index) ) * dz_inv;
347 }
else if (SurfLayer_on_zlo || SurfLayer_on_zhi) {
349 zflux(i,j,k) = hfx_z(i,j,k);
351 zflux(i,j,k) = qfx1_z(i,j,k);
356 zflux(i,j,k) = -rhoAlpha * (cell_prim(i, j, k, prim_index) - cell_prim(i, j, k-1, prim_index)) * dz_inv;
360 if (!(SurfLayer_on_zlo || SurfLayer_on_zhi)) {
361 hfx_z(i,j,k) = zflux(i,j,k);
364 if (!(SurfLayer_on_zlo || SurfLayer_on_zhi)) {
365 qfx1_z(i,j,k) = zflux(i,j,k);
368 qfx2_z(i,j,k) = zflux(i,j,k);
373 ParallelFor(xbx, [=] AMREX_GPU_DEVICE (
int i,
int j,
int k) noexcept
375 const int prim_index = qty_index - 1;
378 Real rhoAlpha = rhoFace * d_alpha_eff[prim_index];
387 ext_dir_on_xlo &= (i == dom_lo.x);
392 ext_dir_on_xhi &= (i == dom_hi.x+1);
393 bool SurfLayer_on_xlo = ( SurfLayer_xlo && i == dom_lo.x);
394 bool SurfLayer_on_xhi = ( SurfLayer_xhi && i == dom_hi.x + 1);
396 if (ext_dir_on_xlo) {
397 xflux(i,j,k) = -rhoAlpha * ( -(
Real(8.)/
three) * cell_prim(i-1, j, k, prim_index)
398 +
three * cell_prim(i , j, k, prim_index)
399 - (
one/
three) * cell_prim(i+1, j, k, prim_index) ) * dx_inv * mf_ux(i,j,0)/mf_uy(i,j,0);
400 }
else if (ext_dir_on_xhi) {
401 xflux(i,j,k) = -rhoAlpha * ( (
Real(8.)/
three) * cell_prim(i , j, k, prim_index)
402 -
three * cell_prim(i-1, j, k, prim_index)
403 + (
one/
three) * cell_prim(i-2, j, k, prim_index) ) * dx_inv * mf_ux(i,j,0)/mf_uy(i,j,0);
404 }
else if ((SurfLayer_on_xlo || SurfLayer_on_xhi) && (qty_index ==
RhoTheta_comp)) {
405 xflux(i,j,k) = hfx_x(i,j,k);
406 }
else if ((SurfLayer_on_xlo || SurfLayer_on_xhi) && (qty_index ==
RhoQ1_comp)) {
407 xflux(i,j,k) = qfx1_x(i,j,k);
409 xflux(i,j,k) = -rhoAlpha * ( cell_prim(i , j, k, prim_index)
410 - cell_prim(i-1, j, k, prim_index) ) * dx_inv * mf_ux(i,j,0)/mf_uy(i,j,0);
414 ParallelFor(ybx, [=] AMREX_GPU_DEVICE (
int i,
int j,
int k) noexcept
416 const int prim_index = qty_index - 1;
419 Real rhoAlpha = rhoFace * d_alpha_eff[prim_index];
428 ext_dir_on_ylo &= (j == dom_lo.y);
433 ext_dir_on_yhi &= (j == dom_hi.y+1);
434 bool SurfLayer_on_ylo = ( SurfLayer_ylo && j == dom_lo.y);
435 bool SurfLayer_on_yhi = ( SurfLayer_yhi && j == dom_hi.y + 1);
437 if (ext_dir_on_ylo) {
438 yflux(i,j,k) = -rhoAlpha * ( -(
Real(8.)/
three) * cell_prim(i, j-1, k, prim_index)
439 +
three * cell_prim(i, j , k, prim_index)
440 - (
one/
three) * cell_prim(i, j+1, k, prim_index) ) * dy_inv * mf_vy(i,j,0)/mf_vx(i,j,0);
441 }
else if (ext_dir_on_yhi) {
442 yflux(i,j,k) = -rhoAlpha * ( (
Real(8.)/
three) * cell_prim(i, j , k, prim_index)
443 -
three * cell_prim(i, j-1, k, prim_index)
444 + (
one/
three) * cell_prim(i, j-2, k, prim_index) ) * dy_inv * mf_vy(i,j,0)/mf_vx(i,j,0);
445 }
else if ((SurfLayer_on_ylo || SurfLayer_on_yhi) && (qty_index ==
RhoTheta_comp)) {
446 yflux(i,j,k) = hfx_y(i,j,k);
447 }
else if ((SurfLayer_on_ylo || SurfLayer_on_yhi) && (qty_index ==
RhoQ1_comp)) {
448 yflux(i,j,k) = qfx1_y(i,j,k);
450 yflux(i,j,k) = -rhoAlpha * (cell_prim(i, j, k, prim_index) - cell_prim(i, j-1, k, prim_index)) * dy_inv * mf_vy(i,j,0)/mf_vx(i,j,0);
454 ParallelFor(zbx, [=] AMREX_GPU_DEVICE (
int i,
int j,
int k) noexcept
456 const int prim_index = qty_index - 1;
459 Real rhoAlpha = rhoFace * d_alpha_eff[prim_index];
470 bool SurfLayer_on_zlo = ( SurfLayer_zlo && k == dom_lo.z);
471 bool SurfLayer_on_zhi = ( SurfLayer_zhi && k == dom_hi.z + 1);
473 if (ext_dir_on_zlo) {
474 zflux(i,j,k) = -rhoAlpha * ( -(
Real(8.)/
three) * cell_prim(i, j, k-1, prim_index)
475 +
three * cell_prim(i, j, k , prim_index)
476 - (
one/
three) * cell_prim(i, j, k+1, prim_index) ) * dz_inv;
477 }
else if (ext_dir_on_zhi) {
478 zflux(i,j,k) = -rhoAlpha * ( (
Real(8.)/
three) * cell_prim(i, j, k , prim_index)
479 -
three * cell_prim(i, j, k-1, prim_index)
480 + (
one/
three) * cell_prim(i, j, k-2, prim_index) ) * dz_inv;
481 }
else if (SurfLayer_on_zlo || SurfLayer_on_zhi) {
483 zflux(i,j,k) = hfx_z(i,j,k);
485 zflux(i,j,k) = qfx1_z(i,j,k);
490 zflux(i,j,k) = -rhoAlpha * (cell_prim(i, j, k, prim_index) - cell_prim(i, j, k-1, prim_index)) * dz_inv;
494 if (!(SurfLayer_on_zlo || SurfLayer_on_zhi)) {
495 hfx_z(i,j,k) = zflux(i,j,k);
498 if (!(SurfLayer_on_zlo || SurfLayer_on_zhi)) {
499 qfx1_z(i,j,k) = zflux(i,j,k);
502 qfx2_z(i,j,k) = zflux(i,j,k);
507 ParallelFor(xbx, [=] AMREX_GPU_DEVICE (
int i,
int j,
int k) noexcept
509 const int prim_index = qty_index - 1;
511 Real rhoAlpha = d_alpha_eff[prim_index];
520 ext_dir_on_xlo &= (i == dom_lo.x);
525 ext_dir_on_xhi &= (i == dom_hi.x+1);
526 bool SurfLayer_on_xlo = ( SurfLayer_xlo && i == dom_lo.x);
527 bool SurfLayer_on_xhi = ( SurfLayer_xhi && i == dom_hi.x + 1);
529 if (ext_dir_on_xlo) {
530 xflux(i,j,k) = -rhoAlpha * ( -(
Real(8.)/
three) * cell_prim(i-1, j, k, prim_index)
531 +
three * cell_prim(i , j, k, prim_index)
532 - (
one/
three) * cell_prim(i+1, j, k, prim_index) ) * dx_inv * mf_ux(i,j,0)/mf_uy(i,j,0);
533 }
else if (ext_dir_on_xhi) {
534 xflux(i,j,k) = -rhoAlpha * ( (
Real(8.)/
three) * cell_prim(i , j, k, prim_index)
535 -
three * cell_prim(i-1, j, k, prim_index)
536 + (
one/
three) * cell_prim(i-2, j, k, prim_index) ) * dx_inv * mf_ux(i,j,0)/mf_uy(i,j,0);
537 }
else if ((SurfLayer_on_xlo || SurfLayer_on_xhi) && (qty_index ==
RhoTheta_comp)) {
538 xflux(i,j,k) = hfx_x(i,j,k);
539 }
else if ((SurfLayer_on_xlo || SurfLayer_on_xhi) && (qty_index ==
RhoQ1_comp)) {
540 xflux(i,j,k) = qfx1_x(i,j,k);
542 xflux(i,j,k) = -rhoAlpha * ( cell_prim(i , j, k, prim_index)
543 - cell_prim(i-1, j, k, prim_index) ) * dx_inv * mf_ux(i,j,0)/mf_uy(i,j,0);
547 ParallelFor(ybx, [=] AMREX_GPU_DEVICE (
int i,
int j,
int k) noexcept
549 const int prim_index = qty_index - 1;
551 Real rhoAlpha = d_alpha_eff[prim_index];
560 ext_dir_on_ylo &= (j == dom_lo.y);
565 ext_dir_on_yhi &= (j == dom_hi.y+1);
566 bool SurfLayer_on_ylo = ( SurfLayer_ylo && j == dom_lo.y);
567 bool SurfLayer_on_yhi = ( SurfLayer_yhi && j == dom_hi.y + 1);
569 if (ext_dir_on_ylo) {
570 yflux(i,j,k) = -rhoAlpha * ( -(
Real(8.)/
three) * cell_prim(i, j-1, k, prim_index)
571 +
three * cell_prim(i, j , k, prim_index)
572 - (
one/
three) * cell_prim(i, j+1, k, prim_index) ) * dy_inv * mf_vy(i,j,0)/mf_vx(i,j,0);
573 }
else if (ext_dir_on_yhi) {
574 yflux(i,j,k) = -rhoAlpha * ( (
Real(8.)/
three) * cell_prim(i, j , k, prim_index)
575 -
three * cell_prim(i, j-1, k, prim_index)
576 + (
one/
three) * cell_prim(i, j-2, k, prim_index) ) * dy_inv * mf_vy(i,j,0)/mf_vx(i,j,0);
577 }
else if ((SurfLayer_on_ylo || SurfLayer_on_yhi) && (qty_index ==
RhoTheta_comp)) {
578 yflux(i,j,k) = hfx_y(i,j,k);
579 }
else if ((SurfLayer_on_ylo || SurfLayer_on_yhi) && (qty_index ==
RhoQ1_comp)) {
580 yflux(i,j,k) = qfx1_y(i,j,k);
582 yflux(i,j,k) = -rhoAlpha * (cell_prim(i, j, k, prim_index) - cell_prim(i, j-1, k, prim_index)) * dy_inv * mf_vy(i,j,0)/mf_vx(i,j,0);
586 ParallelFor(zbx, [=] AMREX_GPU_DEVICE (
int i,
int j,
int k) noexcept
588 const int prim_index = qty_index - 1;
590 Real rhoAlpha = d_alpha_eff[prim_index];
601 bool SurfLayer_on_zlo = ( SurfLayer_zlo && k == dom_lo.z);
602 bool SurfLayer_on_zhi = ( SurfLayer_zhi && k == dom_hi.z + 1);
604 if (ext_dir_on_zlo) {
605 zflux(i,j,k) = -rhoAlpha * ( -(
Real(8.)/
three) * cell_prim(i, j, k-1, prim_index)
606 +
three * cell_prim(i, j, k , prim_index)
607 - (
one/
three) * cell_prim(i, j, k+1, prim_index) ) * dz_inv;
608 }
else if (ext_dir_on_zhi) {
609 zflux(i,j,k) = -rhoAlpha * ( (
Real(8.)/
three) * cell_prim(i, j, k , prim_index)
610 -
three * cell_prim(i, j, k-1, prim_index)
611 + (
one/
three) * cell_prim(i, j, k-2, prim_index) ) * dz_inv;
612 }
else if (SurfLayer_on_zlo || SurfLayer_on_zhi) {
614 zflux(i,j,k) = hfx_z(i,j,k);
616 zflux(i,j,k) = qfx1_z(i,j,k);
621 zflux(i,j,k) = -rhoAlpha * (cell_prim(i, j, k, prim_index) - cell_prim(i, j, k-1, prim_index)) * dz_inv;
625 if (!(SurfLayer_on_zlo || SurfLayer_on_zhi)) {
626 hfx_z(i,j,k) = zflux(i,j,k);
629 if (!(SurfLayer_on_zlo || SurfLayer_on_zhi)) {
630 qfx1_z(i,j,k) = zflux(i,j,k);
633 qfx2_z(i,j,k) = zflux(i,j,k);
642 ParallelFor(zbx, [=] AMREX_GPU_DEVICE (
int i,
int j,
int k) noexcept
644 zflux(i,j,k) *= explicit_fac;
649 ParallelFor(bx,[=] AMREX_GPU_DEVICE (
int i,
int j,
int k) noexcept
651 Real mfsq = mf_mx(i,j,0) * mf_my(i,j,0);
652 cell_rhs(i,j,k,qty_index) -= (xflux(i+1,j ,k ) - xflux(i, j, k)) * dx_inv * mfsq
653 +(yflux(i ,j+1,k ) - yflux(i, j, k)) * dy_inv * mfsq
654 +(zflux(i ,j ,k+1) - zflux(i, j, k)) * dz_inv;
void DiffusionSrcForState_N(const Box &bx, const Box &domain, int start_comp, int num_comp, const Array4< const Real > &u, const Array4< const Real > &v, const Array4< const Real > &cell_data, const Array4< const Real > &cell_prim, const Array4< Real > &cell_rhs, const Array4< Real > &xflux, const Array4< Real > &yflux, const Array4< Real > &zflux, const GpuArray< Real, AMREX_SPACEDIM > &cellSizeInv, const Array4< const Real > &SmnSmn_a, const Array4< const Real > &mf_mx, const Array4< const Real > &mf_ux, const Array4< const Real > &mf_vx, const Array4< const Real > &mf_my, const Array4< const Real > &mf_uy, const Array4< const Real > &mf_vy, Array4< Real > &hfx_x, Array4< Real > &hfx_y, Array4< Real > &hfx_z, Array4< Real > &qfx1_x, Array4< Real > &qfx1_y, Array4< Real > &qfx1_z, Array4< Real > &qfx2_z, Array4< Real > &diss, const Array4< const Real > &mu_turb, const SolverChoice &solverChoice, const int level, const Array4< const Real > &tm_arr, const GpuArray< Real, AMREX_SPACEDIM > grav_gpu, const BCRec *bc_ptr, const bool use_SurfLayer, const Vector< std::unique_ptr< SurfaceLayer >> &SurfLayer, const Real implicit_fac)
Definition: ERF_DiffusionSrcForState_N.cpp:44
#define RhoScalar_comp
Definition: ERF_IndexDefines.H:43
#define Rho_comp
Definition: ERF_IndexDefines.H:39
#define RhoTheta_comp
Definition: ERF_IndexDefines.H:40
#define RhoQ2_comp
Definition: ERF_IndexDefines.H:46
#define NSCALARS
Definition: ERF_IndexDefines.H:16
#define RhoQ1_comp
Definition: ERF_IndexDefines.H:45
#define PrimScalar_comp
Definition: ERF_IndexDefines.H:60
#define RhoKE_comp
Definition: ERF_IndexDefines.H:41
ParallelFor(fab_box, [=] AMREX_GPU_DEVICE(int i, int j, int k) { qrcuten_arr(i, j, k)=Real(0);qscuten_arr(i, j, k)=Real(0);qicuten_arr(i, j, k)=Real(0);})
constexpr amrex::Real three
Definition: ERF_NumericalConstants.H:32
constexpr amrex::Real one
Definition: ERF_NumericalConstants.H:30
constexpr amrex::Real zero
Definition: ERF_NumericalConstants.H:29
constexpr amrex::Real myhalf
Definition: ERF_NumericalConstants.H:34
amrex::Real Real
Definition: ERF_ShocInterface.H:19
@ RhoScalar_bc_comp
Definition: ERF_IndexDefines.H:93
@ ext_dir
Definition: ERF_IndexDefines.H:297
@ ext_dir_prim
Definition: ERF_IndexDefines.H:300
@ ext_dir_upwind
Definition: ERF_IndexDefines.H:305
Functor for inverse vertical spacings with constant grid spacing.
Definition: ERF_PBLModels.H:417